Table of contents
Open Table of contents
Lucene是什么
Lucene 是 Apache 开源的全文检索工具包,也是搜索引擎最核心的底层库之一,它主要负责索引、分词、查询、排序等能力,适合用来在应用中实现高性能的本地搜索功能;但 Lucene 本身并不是完整的搜索引擎系统,它不直接提供 Web API、分布式集群等能力,因此通常需要结合其他组件或在更上层的搜索平台中使用,才能形成完整的搜索服务,例如 Elasticsearch、Solr 这类基于 Lucene 的搜索平台。
架构是什么
名词定义
Term : 分词后每一个词项
Term dictionary : 排好序的词项
Posting list : 含有这个词的文档id的集合
Inverted index : 倒排索引,Term dictionary+Posting list
Term index : Term Dictionary 数据量很大,所以使用Term dictionary构建目录树加速搜索。使用FST来实现。
Store fields : 存放文档id-文档本身
Doc values : 存放文档字段,用于排序、统计等
Point value : 使用BKD树,用于数值数据的索引和区间查询
Segment : 倒排索引+Term index+Store fields+Doc values构成一个segment,它是一个具备完整搜索功能的最小单元
Lucene : 每次写入都更新segment性能不好。所以制定规则:segment 一旦生成,则不能再被修改。如果还有新的文档要写入,那就生成新的 segment。这样老的 segment 只需要负责读,写则生成新的 segment。读时并发读多个segment。同时不定期合并多个小 segment,变成一个大 segment(segment merging),使segment数量可控。
Field : 字段,一个文档里有多个field,比如标题、正文、摘要…它是一种逻辑上的结构,实际存储时,每个字段根据设置存到不同的数据结构。
数据架构
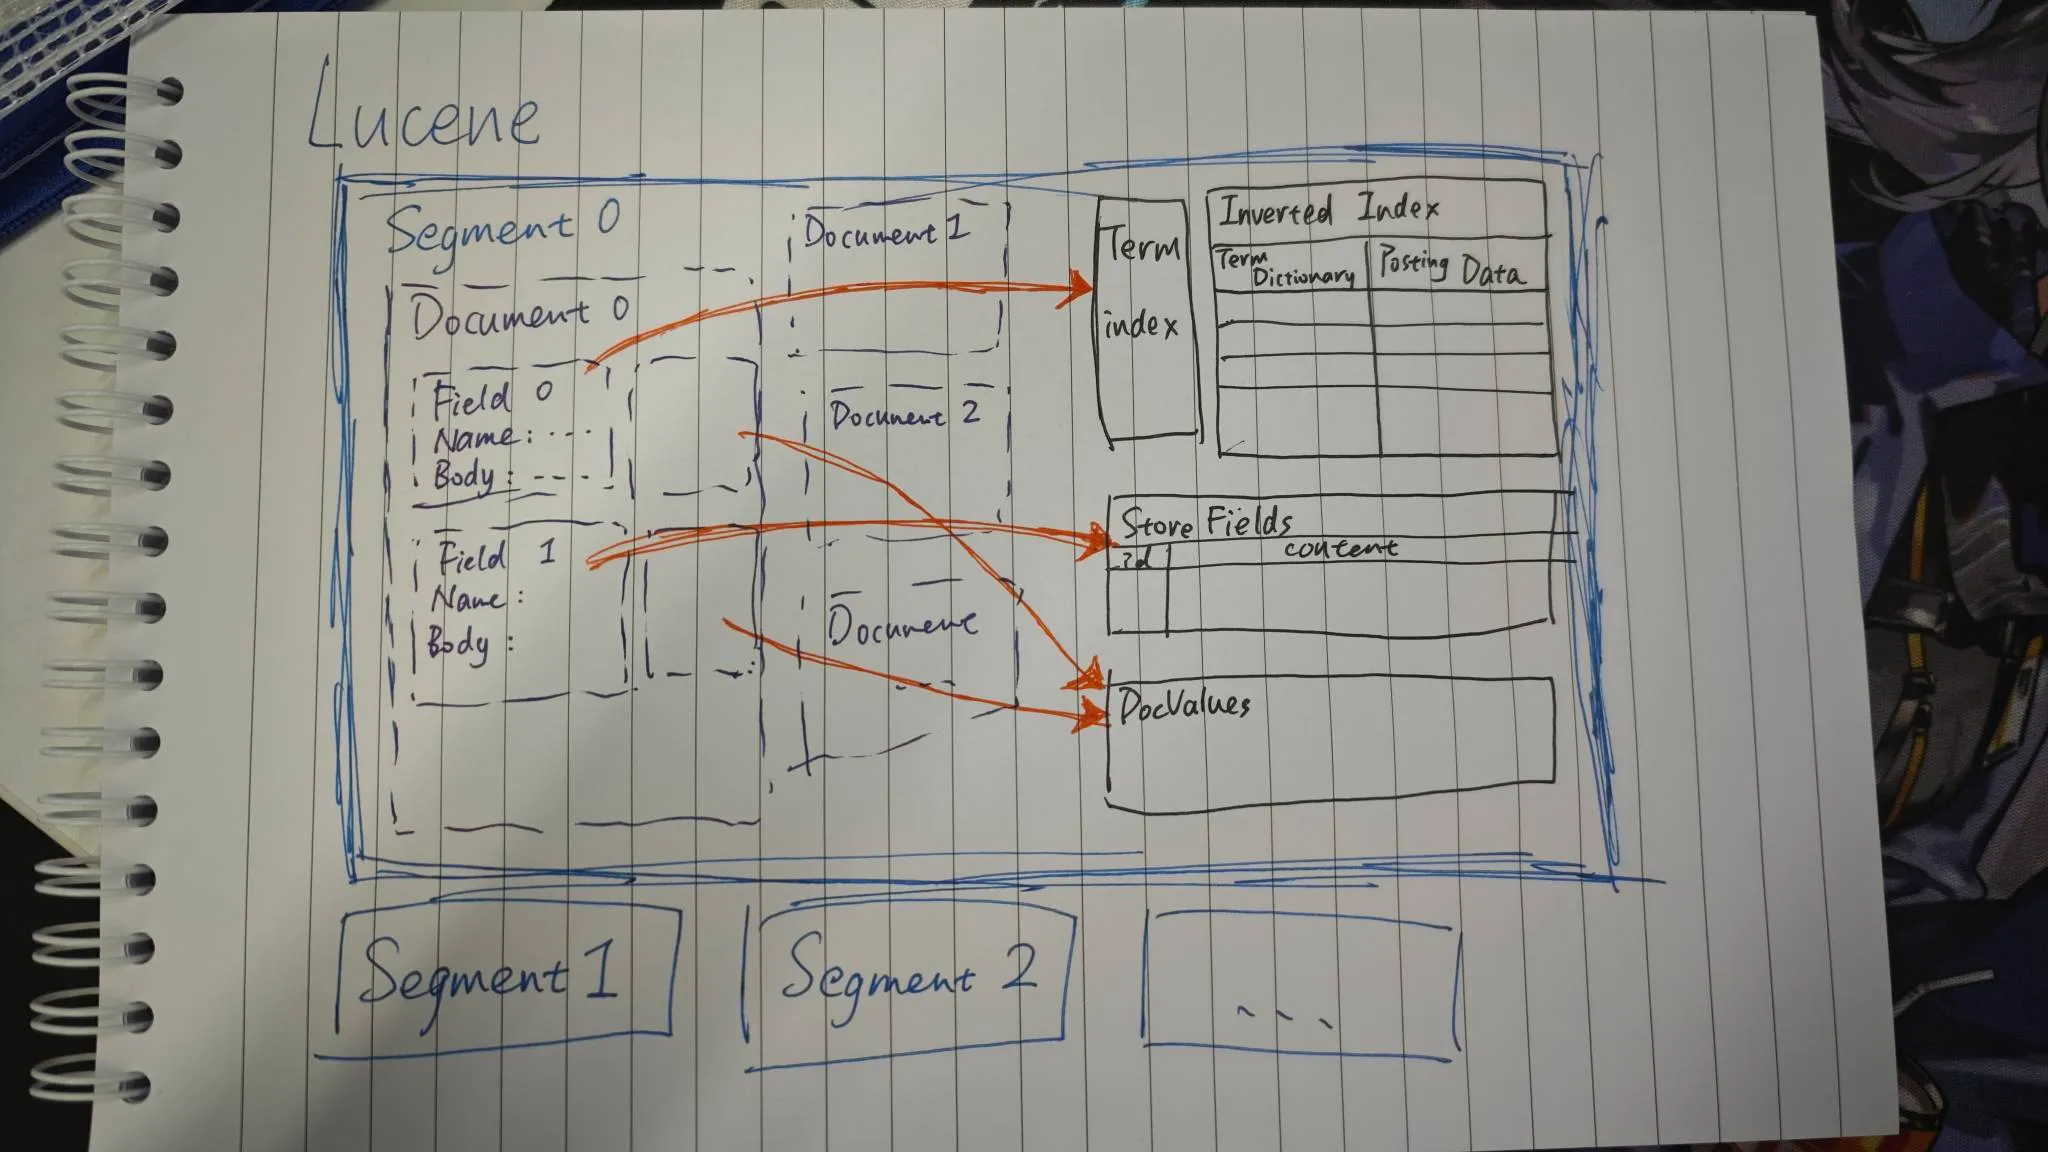
Field类型
通过 FieldType 控制字段进入哪些底层数据结构
//例子
doc.add(new IntPoint("price", price));                  // 范围查询
doc.add(new NumericDocValuesField("price_sort", price)); // 排序/聚合
doc.add(new StoredField("price", price));                // 返回展示
Term index
使用FST(Finite State Transducer,有限状态转换器)来高效地索引词典中的 term。Lucene 的倒排索引中 term dictionary 通常按字典序存储所有词项,而 FST 作为 term dictionary 的内存索引结构,可以把大量有公共前缀的 term 压缩成共享路径,从而显著减少内存占用。查询时,Lucene 可以通过 FST 快速定位某个 term 所在的词典块或文件位置,再进一步读取磁盘上的 term dictionary 和 posting list。相比普通哈希表或树结构,FST 既支持快速查找、前缀查询、范围遍历等操作,又具有很高的压缩率,因此非常适合用于搜索引擎中大规模、有序 term 集合的索引。
例子:
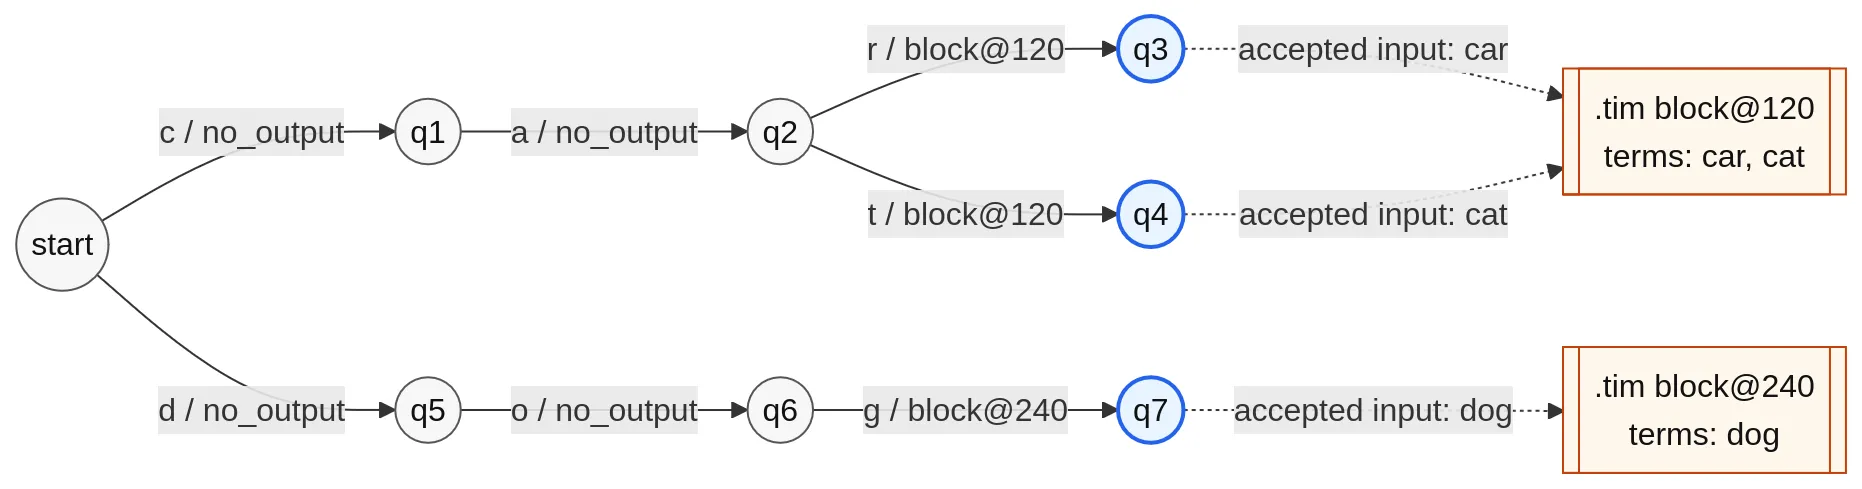
节点有前缀状态和接受态,查询时先沿 .tip 里的 FST 走,拿到指向 .tim 某个 block 的文件指针,再去 .tim 读真正的词典块。
倒排索引
Lucene 的倒排索引是一种“从词到文档”的索引结构:它会把文档内容先分词,得到一个个词项(Term),然后记录每个词项出现在哪些文档中,以及出现的位置、频率等信息。这样查询某个关键词时,Lucene 不需要逐篇扫描文档,而是直接通过词项找到相关文档列表,因此检索速度很快。
例子:
-
正序:
-
倒排:(docId之外的是可选项;这里只写了三个词,后续的省略了)
Store Fields
用于根据文档 ID 取回原始字段内容,存储上按行存储。
例子:
Point Values
BKD (Block k-dimensional tree)树可以理解为一种面向磁盘优化的 k-d tree:它会按照维度递归划分数据点,将大量点组织成树形结构,并在叶子节点中存储实际点值。查询时,Lucene 可以根据查询范围快速判断某个节点对应的空间区域是否完全匹配、完全不匹配或需要继续向下检查,从而大幅减少需要扫描的数据量。
BKD 的磁盘优化主要体现在把点数据按块连续存储,并通过树形边界判断尽早跳过不相关的数据块,减少随机 IO。查询时先读很小的内部索引,再决定是否需要读叶子块,所以能显著降低实际需要访问的磁盘数据量。
例子:
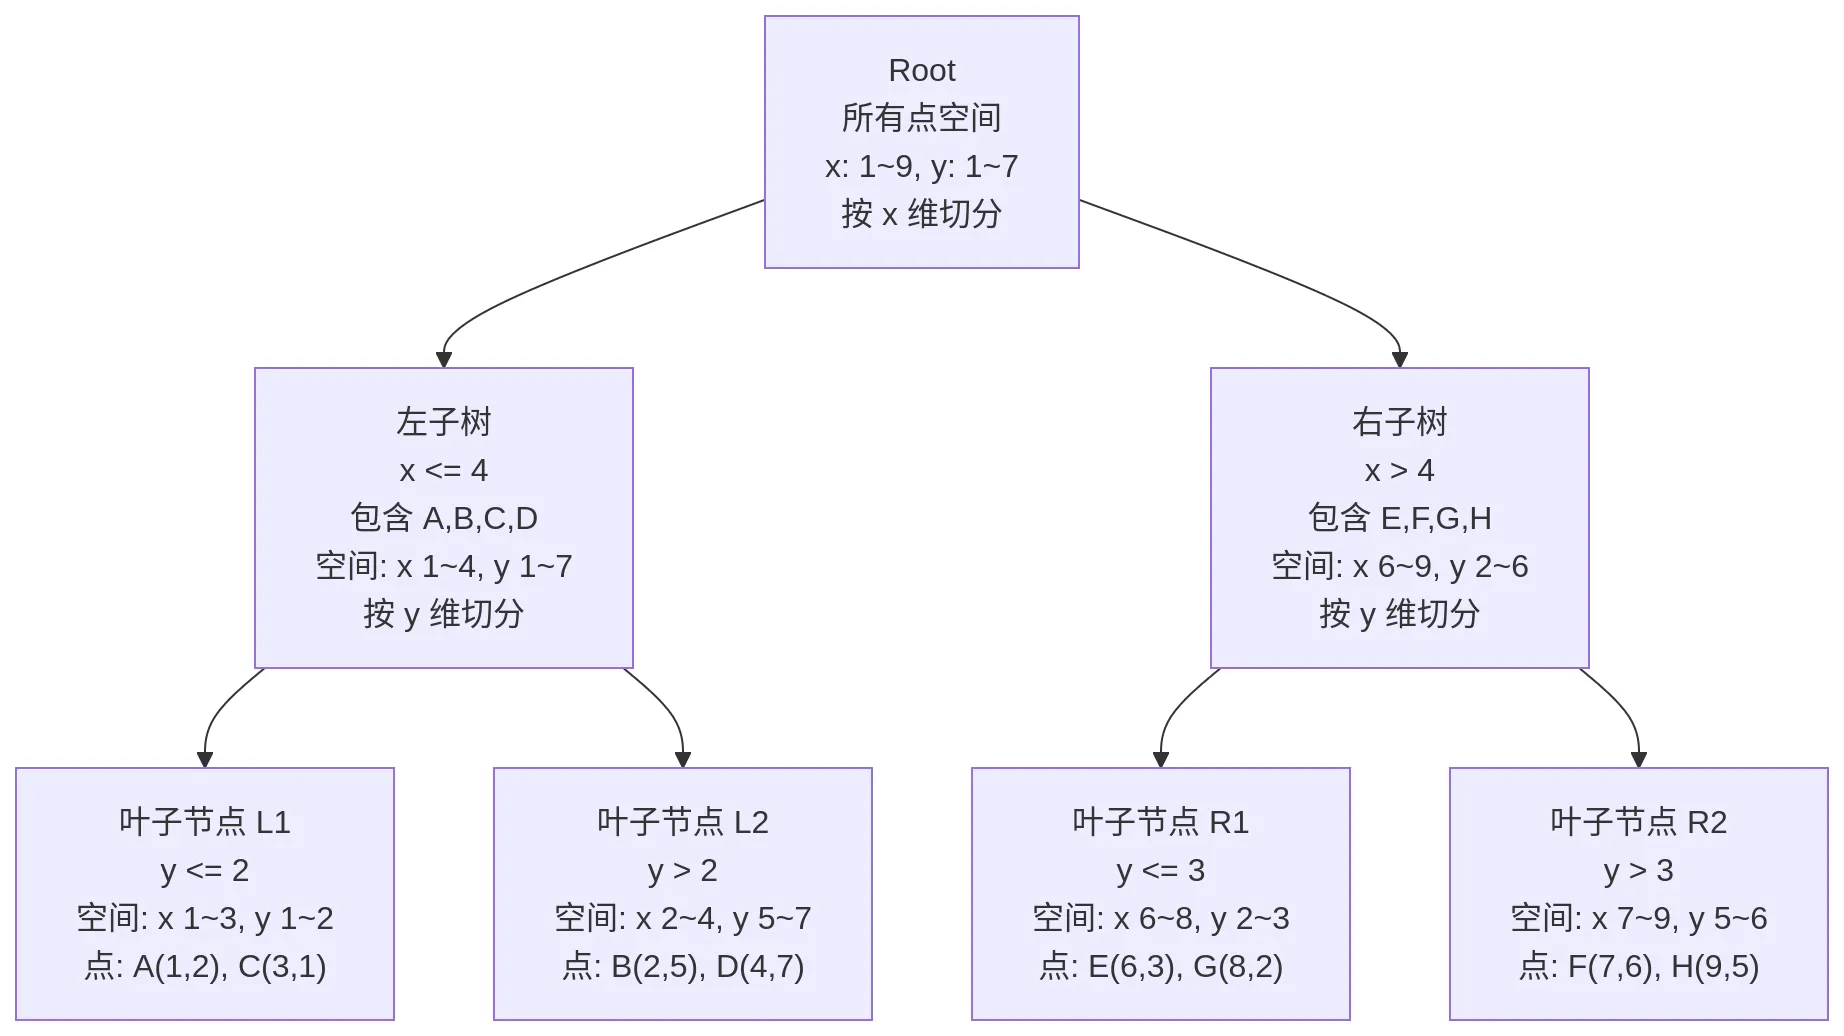
Doc Values
每个字段各自有一份 doc values,用于排序、统计等,存储上按列存储。
例子:
实现架构
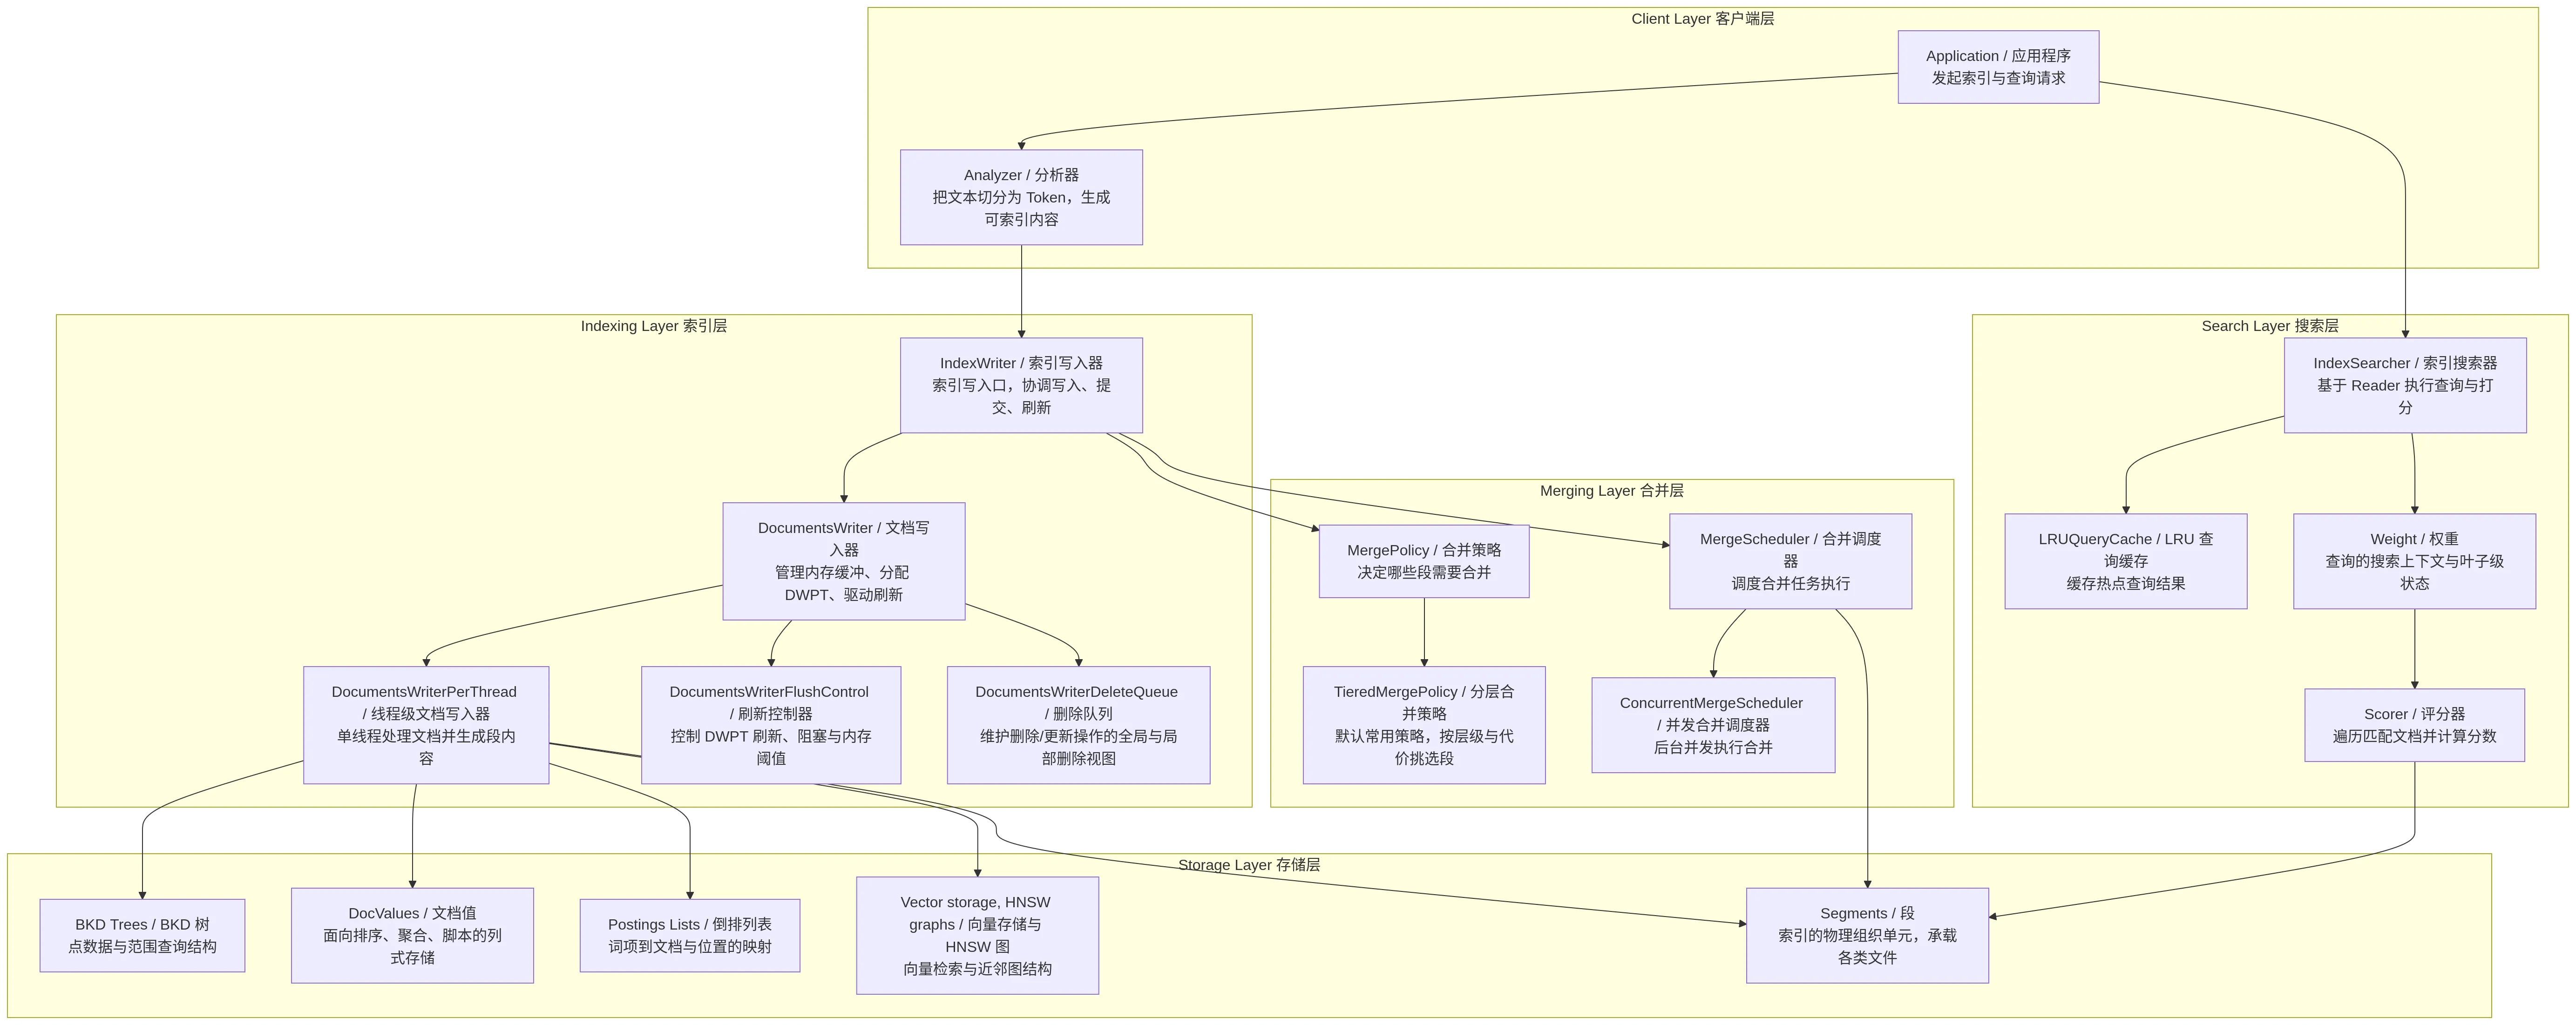
客户端层负责接收应用侧的索引和查询请求;索引层负责把文档转换为可持久化的索引结构;存储层承载倒排列表、DocValues、BKD树、向量图和 segment 等底层数据组织;合并层负责维护 segment 的生命周期;搜索层负责基于索引结构执行查询、缓存和评分。整体上,core 模块提供主要的写入、读取、搜索和存储抽象,codecs 及相关工具模块提供底层格式和专用数据结构实现。
执行流程是什么
写入流程

Lucene 的写入先把业务数据转成 Document,再通过 IndexWriter.addDocument() 进入索引构建链路。这里保持主链路视角:IndexWriter 把写入交给 DocumentsWriter,再进入 DocumentsWriterPerThread 和 IndexingChain,先缓存,后由 flush 生成新的 Segment。commit() 会记录索引元数据,形成一个提交点segments_N,后台则继续按照合并策略执行 Segment Merge。
使用示例:
Analyzer analyzer = new StandardAnalyzer();
IndexWriterConfig config = new IndexWriterConfig(analyzer);

try (IndexWriter writer = new IndexWriter(directory, config)) {
  Document doc = new Document();
  doc.add(new TextField("title", "hello lucene", Field.Store.YES));
  doc.add(new TextField("body", "lucene write example", Field.Store.NO));
  writer.addDocument(doc);
  writer.commit();
}
合并流程

合并主链路从 IndexWriter.maybeMerge() 开始,IndexWriter 通过 updatePendingMerges() 调用 MergePolicy.findMerges() 或强制合并相关策略,由 MergePolicy 返回要合并的段;随后 IndexWriter.executeMerge() 交给 MergeScheduler.merge() 调度,默认 ConcurrentMergeScheduler.merge() 会启动合并执行;真正重写新段发生在 IndexWriter.merge() / IndexWriter.mergeMiddle() 中,并调用 SegmentMerger.merge(),最后 IndexWriter.commitMerge() 用新 segment 替换旧 segment。
使用示例:
try (IndexWriter writer = new IndexWriter(directory, config)) {
  writer.forceMerge(1);
}
删除流程
删除请求先进入 DocumentsWriterDeleteQueue,不会立刻改写磁盘上的旧 segment。等到 flush 或 commit 时,删除标记才会应用到活跃段,后续再靠合并清掉真正无效的数据。
使用示例:
try (IndexWriter writer = new IndexWriter(directory, config)) {
  writer.deleteDocuments(new Term("id", "1001"));
  writer.deleteDocuments(new TermQuery(new Term("category", "draft")));
  writer.commit();
}
修改流程
先把新文档写入当前写入线程的内存段里,成功后再把用于定位旧文档的 term转成删除操作放进删除队列,随后在 flush 时把“新增文档 + 旧文档删除标记”一起提交出去,所以对外看起来是一次原子替换;旧文档不会立刻从原 segment 里物理抹掉,只是被标记为 deleted,等后续 merge 时才真正回收。
使用示例:
try (IndexWriter writer = new IndexWriter(directory, config)) {
  Document updated = new Document();
  updated.add(new StringField("id", "1001", Field.Store.YES));
  updated.add(new TextField("title", "new title", Field.Store.YES));
  writer.updateDocument(new Term("id", "1001"), updated);
  writer.commit();
}
查询流程

Lucene 执行查询时,IndexSearcher 会先对用户传入的 Query 进行 rewrite,把一些高级或复杂查询改写成底层可执行的查询形式;然后基于当前索引为查询创建 Weight,它相当于查询的执行计划,包含评分和统计信息。由于 Lucene 索引由多个 segment 组成,每个 leaf 对应一个 segment,所以搜索会在每个 leaf 上分别执行:Weight 会为每个 leaf 创建 Scorer 或 BulkScorer,用于遍历命中文档并计算分数;命中的文档会交给 LeafCollector 收集。最后,各个 segment 或线程中的收集结果会由 CollectorManager 进行合并,形成最终返回给用户的 TopDocs。
使用DirectoryReader.open(directory)时需要手动refresh,打开新的IndexReader / Searcher,新的写入才会可见。
使用示例:
try (DirectoryReader reader = DirectoryReader.open(directory)) {
  IndexSearcher searcher = new IndexSearcher(reader);
  Query query = new TermQuery(new Term("body", "lucene"));
  TopDocs topDocs = searcher.search(query, 10);

  StoredFields storedFields = searcher.storedFields();
  for (ScoreDoc hit : topDocs.scoreDocs) {
    Document doc = storedFields.document(hit.doc);
  }
}
常见查询类型
TermQuery:精确词项查询
BooleanQuery:布尔组合查询
PhraseQuery:短语查询
PrefixQuery:前缀查询
RangeQuery:范围查询
其他
底层文件
| 文件 | 对应的数据架构 | 含义 |
|---|---|---|
segments_N | Index / Commit Point | 整个索引的最新提交点,记录当前可见的 segment 列表、版本、计数器和提交元数据。打开索引时先读它。 |
.si、.fnm | Segment / Field 元信息 | .si 记录单个 segment 的身份、codec、版本、文件集合和删除代数;.fnm 记录每个 field 的编号、名称以及 indexed、stored、docValues、points、vectors、norms 等能力。 |
.cfs、.cfe | Compound Segment File | 复合文件封装。.cfs 把一个 segment 的多个小文件打包到一个文件里,.cfe 记录被打包文件在 .cfs 里的名称、偏移和长度。 |
.tim、.tip、.tmd | Inverted Index / Term Dictionary | 倒排索引的词典层。.tim 保存 field + term、统计信息和 postings 入口;.tip 加速定位词典块;.tmd 保存字段级 term 统计、文件指针和编码参数。 |
.doc、.pos、.pay、.psm | Inverted Index / Posting Data | 倒排索引的 postings 层。.doc 保存 docID、词频和跳表;.pos 保存词项位置;.pay 保存 payload/offset;.psm 保存 skip 元数据,用于快速跳过不可能命中的 docID 区间。 |
.fdm、.fdx、.fdt | Stored Fields | 原始可取回字段值。.fdm 保存块元数据,.fdx 按 docID 定位压缩块,.fdt 保存压缩后的字段数据,例如 title、业务 id、摘要等。 |
.nvm、.nvd | Norms | 评分用的 per-doc 小数值数据。.nvm 保存字段和编码元数据,.nvd 保存字段长度归一化等实际数据,BM25 等相似度模型会读取。 |
.dvm、.dvd | DocValues | 列式字段数据。.dvm 保存类型、编码方式和数据位置,.dvd 保存列式数据主体,服务排序、聚合、函数查询、脚本读取和部分过滤场景。 |
.kdm、.kdi、.kdd | Points / BKD | 数值、日期、地理字段等点数据索引。.kdm 保存字段和入口元数据,.kdi 是 BKD 树索引,.kdd 保存点值和 docID。 |
.vem、.vex、.vec | Vector Search / HNSW | 向量检索结构。.vem 保存向量字段、维度、相似度函数和图入口元数据,.vex 保存 HNSW 近邻图,.vec 保存原始或量化后的向量值。 |
.liv | Live Docs / Deletes | 活跃文档位图,记录哪些 docID 已删除但尚未通过 merge 清理;查询时用它过滤删除文档。 |
搜索评分算法
Lucene 默认搜索评分是 BM25Similarity,BM25 通常认为是由 Stephen Robertson 和 Karen Spärck Jones 等人在 Okapi 信息检索项目中提出和发展出来的, 可以看作是对 TF-IDF 思想的改进和扩展,是全文检索领域非常经典、成熟、通用的相关性排序算法。
boost(查询权重)
boost 表示查询附加权重。 它来自查询本身,用来放大某个词、子句或整条查询的影响。 默认一般是 1.0。
idf(逆文档频率)
idf 表示词项的稀有度。 词越少出现在文档中,idf 越大。 Lucene 的实现是:
其中:包含该词的文档数 :字段中文档总数
原始的在极端情况下不够平滑,例如某个词出现在所有文档中时 idf 会直接变成 0,而经典概率 idf 还可能产生负数。因此 BM25 使用:其中 +0.5 用于平滑小数据和极端情况,外层的 +1 保证结果始终为正;同时,它仍然保留了 idf 的核心思想——词出现得越少,区分能力越强、权重越高,出现得越普遍,权重越接近 0。
tf(词频饱和项)
tf 表示词在文档中的出现次数影响。 它不是线性增长,而是逐渐饱和。 Lucene 的实现是:
-
:词项在文档中的出现次数
-
:控制词频增长的饱和速度
-
:控制字段长度惩罚强度
-
:当前字段长度
-
avgdl:平均字段长度原始 TF 通常按词频线性增长,容易导致一个词重复 10 次就比重复 1 次高很多,而且长文档因为包含更多词而天然更容易命中。BM25 使用让词频收益逐渐饱和,即一个词从出现 0 次变成 1 次很重要,但从 100 次变成 101 次几乎没有额外价值,从而抑制关键词堆砌;同时通过进行文档长度归一化,适当降低长文档因长度而获得的不公平优势,其中
k_1控制词频饱和速度,b控制文档长度归一化程度。
BM25 在项目中的使用流程
建索引时设置 Similarity
在写入索引前,通过 IndexWriterConfig.setSimilarity(...) 指定 BM25Similarity。 这一步决定索引时如何计算 norm。norm是预计算的这个字段的长度,相当于上面公式的D。
搜索时设置 Similarity
在查询前,通过 IndexSearcher.setSimilarity(...) 使用同一个 BM25Similarity。 这样查询阶段会按同一套公式解释 norm 和分数。
索引时写入 norm
Lucene 在索引阶段调用 Similarity.computeNorm()。 默认会把字段长度压缩成一个字节保存。
查询时计算分数
Lucene 在查询阶段调用 Similarity.scorer()。 它先拿到 docFreq、docCount、avgdl 等统计信息,再对每个命中文档调用 SimScorer.score(freq, norm)。
参考资料
https://github\.com/apache/lucene
https://deepwiki\.com/apache/lucene
[elasticSearch 是什么?工作原理是怎么样的?](golang全栈指南 - 数据库/微服务/Kubernetes/Docker 等全站资源)
[深度解析 Lucene 轻量级全文索引实现原理](https://zhuanlan\.zhihu\.com/p/391168762\)
前期学习
MySQL InnoDB引擎 采用 B+ 树作为索引
B+树对读取优化好
LSM-tree牺牲少量读性能换取写性能
FST 后面有介绍
CAP 一致性、可用性、分区容错性,只能同时满足CP/AP
https://zhuanlan.zhihu.com/p/636768391
BASE是由 Basically Available(基本可用),Soft state(软状态),和 Eventually consistent(最终一致性)三个短语的缩写。